Jev —Jev IA, como se busca en español— es el primer modelo de TypeSafe AI y salió el 15 de septiembre de 2026. No escribe texto: recibe un contexto y unas preguntas cerradas y devuelve una opción, una puntuación o una probabilidad que un programa usa directamente. Sirve para clasificar, enrutar y filtrar mensajes en décimas de segundo, según TypeSafe, y a un coste casi nulo. No sirve para chatear, y su documentación avisa de que rinde mejor en inglés.
Lo último, a 11 de octubre de 2026: el 9 de octubre TypeSafe anunció una ronda de 870 millones de dólares con una valoración de 7.500 millones, liderada por Andreessen Horowitz, y ese mismo día Microsoft sacó un rival directo al mismo precio, Microsoft-Decision-1. OpenAI ya tiene el suyo en beta. Está todo más abajo, en «Lo último de Jev».
Todo lo que sigue sale del blog y la documentación oficiales de TypeSafe AI, consultados el 25 de septiembre de 2026 y revisados de nuevo el 28 de septiembre y el 11 de octubre. Están en inglés y la traducción es propia. Antes de escribir hemos revisado también quién sale arriba en Google al buscar «jev ai» y qué contesta el Modo IA, porque hay dos confusiones que conviene deshacer antes de probarlo: qué web es la oficial y qué significa exactamente eso de que «no alucina». Donde hay un cálculo o una medición nuestra, está marcado como tal.
Qué es Jev y quién está detrás
Jev es el nombre del modelo y TypeSafe AI, la empresa que lo ha creado. «Jev IA» y «Jev AI» son como se busca, pero el producto se llama solo Jev. TypeSafe lo presentó el 15 de septiembre de 2026 en el artículo de lanzamiento de su blog, firmado por su fundador, Diogo Almeida, y lo abrió ese día en acceso anticipado, sacando desarrolladores de la lista de espera de forma gradual.
La página de equipo de TypeSafe presenta a Almeida como consejero delegado y coinventor de RLHF e InstructGPT, los métodos que llevaron a ChatGPT, y a Sasha Sheng y Erik Gafni como directores de operaciones y de tecnología. La empresa trabaja desde San Francisco.
Los dos nombres tienen explicación en el mismo anuncio. TypeSafe llama a esta familia «System One Models», modelos de Sistema 1, por la distinción de Daniel Kahneman entre el pensamiento rápido e intuitivo y el lento y deliberado. Y Jev viene de William Stanley Jevons, el economista que observó que abaratar un recurso dispara su consumo: la apuesta de la empresa es que cada bajada de precio de la inteligencia artificial abre muchos más usos.
La versión vigente es jev-1.13.0, según la página de modelos de la documentación, y se llama con el alias jev-latest. Hay además un segundo alias, jev-preview, para las versiones previas a la oficial; el 11 de octubre apuntaba al mismo modelo porque no había ninguna en pruebas. La introducción de la documentación lo resume en una frase: envía un estado y preguntas tipadas y recibe respuestas estructuradas que tu código puede usar directamente.
Lo último de Jev: 870 millones y dos rivales con el mismo formato
La ronda. El 9 de octubre de 2026 TypeSafe anunció en su blog una serie A de 870 millones de dólares con una valoración de 7.500 millones. La lidera Andreessen Horowitz, con Sequoia Capital y DCVC, que ya era inversor, y Martin Casado entra en el consejo. El anuncio de Andreessen Horowitz, del mismo día, dice que Jev es el modelo que más rápido ha crecido de los que han visto: un billón de tokens en sus tres primeros días.
Un detalle que no cuadra entre las dos fuentes, y que es comprobación nuestra: TypeSafe escribe que «un tercio» de las empresas del Fortune 500 usa Jev, y Andreessen Horowitz, que lo ha integrado «el 25 %». Ninguna de las dos explica cómo lo cuenta, así que tómalo como lo que es, una cifra de quien vende o de quien invierte.
El primer caso publicado. TypeSafe ha publicado el caso de Jack & Jill, un mercado de empleo con agentes de IA que cambió Gemini 3.1 Flash Lite por Jev en la criba inicial de candidatos. Según TypeSafe, con la misma calidad, un 88 % menos de coste —de 0,755 a 0,092 dólares por cada mil candidatos— y la mitad de tiempo. Es un caso contado por el fabricante, no una prueba independiente.
Los rivales. Jev ya no es el único modelo que responde con decisiones en vez de texto:
- OpenAI tiene la API de decisiones, en beta pública y con GPT-6 Luna como único modelo. Usa los mismos tres tipos de pregunta con otros nombres —verdadero o falso, elegir y puntuar— y, a diferencia de Jev, también evalúa imágenes. OpenAI dice que la sacará de la beta «en las próximas semanas».
- Microsoft presentó el 9 de octubre Microsoft-Decision-1, disponible en Microsoft Foundry y en OpenRouter. Cuesta exactamente lo mismo que Jev, 0,042 dólares por millón de tokens de entrada y la salida gratis, y está construido a partir de Qwen3.5-9B. Microsoft afirma que supera a los demás modelos de decisión, Jev incluido, en sus propias pruebas, que son eso, suyas.
Para una pyme, la lectura práctica es que el formato se está convirtiendo en una categoría, y eso es una buena noticia: la forma de trabajar que se explica en este artículo ya no te ata a un solo proveedor.
Cómo funciona: un estado, varias preguntas y una probabilidad por respuesta
A Jev se le manda un «estado», que es el texto o los datos sobre los que hay que decidir, y una o varias preguntas de tipo cerrado. Evalúa todas las preguntas a la vez contra ese mismo estado, en una sola llamada, y la documentación asegura que añadir preguntas apenas cambia el tiempo de respuesta. Hay tres tipos de pregunta, que TypeSafe llama primitivas:
- Choice, elegir. Elige una opción de una lista que defines tú. Devuelve la opción elegida, la probabilidad de cada una y un grado de confianza. Ejemplo: ¿este mensaje es para pedir cita, para cambiarla, para preguntar un precio o es otra cosa? El anuncio fija el máximo en 255 opciones.
- Score, puntuar. Sitúa el estado en una escala de niveles que describes con palabras. Devuelve la puntuación, la probabilidad de cada nivel y la confianza. Ejemplo: urgencia 0 si no hay prisa, 1 si quiere cita pronto y 2 si hay dolor o un problema que no puede esperar.
- Noul, verdadero o falso. Evalúa una afirmación y devuelve la probabilidad de que sea cierta, entre 0 y 1. Ejemplo: «el cliente pide hablar con una persona».
Un apunte sobre el nombre de la tercera, porque circula mal escrito. La respuesta del Modo IA de Google que consultamos el 25 de septiembre la llamaba «NLE». En la documentación de las primitivas se llama Noul, y en el SDK de IA de Vercel el mismo tipo de pregunta se escribe boolean.
La confianza es la parte más útil para un negocio. Según la página de confianza de la documentación, se calcula a partir de lo concentradas que estén las probabilidades: si una opción se lleva casi todo, la confianza es alta; si el reparto es plano, baja. TypeSafe propone tres franjas: confianza alta, se actúa solo; media, se pide confirmación o revisión; baja, no se actúa y pasa a una persona. Y añade que el umbral no es un número único, sino que sube cuanto más caro sea equivocarse.
Lo que admite de entrada es solo texto: una cadena, un objeto JSON o una lista de textos. Ni imágenes, ni audio, ni vídeo. Cada petición puede ocupar hasta 64k tokens, con un límite de 32k para el estado más la pregunta más larga.
Cómo usar Jev paso a paso
Jev se usa de cuatro maneras, de la que no pide programar a la que se integra en tu software. Todas salen de la guía de inicio rápido y de la referencia de la API de TypeSafe. No hay aplicación que descargar ni chat al que escribir, y en todos los casos hace falta una cuenta: TypeSafe abrió el acceso el 15 de septiembre como acceso anticipado, dando paso poco a poco a los desarrolladores de su lista de espera.
1. Sin programar, en el Playground
- Entra con tu cuenta en la consola de TypeSafe, console.typesafe.ai, y abre el Playground.
- Pega como estado el texto sobre el que quieres decidir, por ejemplo un mensaje real de un cliente sin su nombre ni su teléfono.
- Añade una pregunta. La guía propone empezar por una de sí o no, del tipo «¿este mensaje expresa urgencia?».
- Añade preguntas de los otros dos tipos y ejecuta: salen todas las respuestas a la vez, con la probabilidad de cada opción y la confianza.
Es la forma más rápida de ver si Jev entiende tus mensajes antes de pedirle nada a un programador.
2. Por API
- Crea una clave en el apartado de claves de la consola.
- Envía una petición
POSTahttps://api.typesafe.ai/v1/systemone, con la clave en la cabeceraAuthorizationcomoBearer. - En el cuerpo van tres campos:
state, con el texto;model, conjev-latesto una versión fija; yquestions, con cada pregunta por su nombre, su tipo (choice,scoreonoul), sus instrucciones y, en las de elegir y puntuar, sus criterios. - La respuesta trae una entrada por pregunta con el valor, las probabilidades y, en las de elegir y puntuar, la confianza. Al final llega un apartado
usagecon los tokens de entrada y de salida; solo los de entrada se facturan.
3. Con los SDK de Python o JavaScript
- Python. Se instala con
pip install typesafe-sdky pide Python 3.10 o posterior. El cliente lee la clave de la variable de entornoTYPESAFE_API_KEYy usajev-latestsi no le indicas otro modelo. - JavaScript. Se instala con
npm install @typesafe-ai/sdky pide Node.js 20 o posterior.
Los dos reintentan solos, con esperas crecientes, cuando una petición supera los límites de uso, según la página de modelos.
4. Desde tu asistente de programación o una pasarela que ya uses
- TypeSafe publica una skill que da a Claude Code, Codex y otros agentes el contexto de su API para que escriban la integración. En Claude Code se instala con
claude plugin marketplace add typesafe-ai/skillsy despuésclaude plugin install typesafe@typesafe-ai, según la página de la skill. - Si ya trabajas con OpenRouter o con Vercel AI Gateway, puedes llamar a Jev desde ahí con su propia clave: el modelo es
~typesafe/jev-latesten OpenRouter ytypesafe-ai/jeven Vercel.
Antes de conectar cualquiera de estas vías a un canal con clientes, lee más abajo lo que dice TypeSafe del español y de dónde procesa los datos, y haz la prueba del apartado «Cómo probarlo con tus mensajes antes de fiarte».
Lo que Jev no hace, empezando por conversar
No es un chat ni sustituye a ChatGPT, Claude o Gemini. No redacta respuestas, no escribe código y no explica su razonamiento. La propia TypeSafe tiene una página, «Jev with coding agents», para quien llega buscando otro motor para su asistente de programación: dice que Jev no es un sustituto del modelo que hay detrás de Claude Code, Cursor o Copilot, y que no existe ningún ajuste que convierta un asistente de ese tipo en uno basado en Jev.
Lo de «cero alucinaciones» necesita letra pequeña. Lo repiten varias webs y la respuesta del Modo IA de Google lo daba como hecho, con un «cero alucinaciones gracias a que sus respuestas están preestablecidas». El anuncio de TypeSafe dice que Jev «no puede alucinar», y lo que respalda esa frase es una garantía concreta: cero errores de tipo. Jev no puede devolver una opción que no hayas definido ni un campo mal formado, porque las respuestas posibles están fijadas de antemano. Pero sí puede elegir la opción equivocada. La página del concepto System One lo dice sin rodeos: la calibración se mide sobre grupos de predicciones y no garantiza que una respuesta concreta sea correcta.
Tiene fallos conocidos, y están documentados. La página de limitaciones de jev-1.13, revisada el 17 de septiembre, empieza reconociendo que el modelo no es perfecto y enumera dónde falla:
- Lee de forma literal: contesta a la pregunta que has escrito, no a la que querías hacer.
- No es una calculadora. No cuenta bien, ni letras ni elementos de una lista.
- Compara mal fechas y plazos, porque las lee como texto.
- Pierde precisión con dobles negaciones y preguntas que obligan a dar varios saltos.
- Se distrae cuando el estado lleva mucho texto que no tiene que ver con la pregunta.
- Un contenido escrito para manipularlo, como una instrucción colada dentro de un mensaje, puede mover su respuesta.
- Se confunde si las instrucciones y los criterios de una pregunta dicen cosas distintas.
La solución que propone TypeSafe es la misma en casi todos los casos: esa parte, al código. Las cuentas, las fechas y los recuentos los hace el programa; Jev se queda con el juicio.
Solo juzga lo que le mandas. TypeSafe recomienda poner en el estado tu propia información —tarifas, políticas, historial— en vez de confiar en lo que el modelo sepa. Tampoco se ajusta con los datos de cada cliente: el mismo modelo sirve a todas las cuentas, y lo que adapta la respuesta a tu negocio es lo que escribes en cada petición.
Cuánto cuesta Jev y si se puede probar gratis
El precio oficial es de 0,042 dólares por millón de tokens de entrada, y los de salida no se cobran. Lo publica la página de modelos, que lo expresa también como 42 dólares por cada mil millones de tokens. Los límites de uso, el 11 de octubre, eran 100.000 tokens y 80 peticiones por segundo, con un aviso: se están ajustando sobre la marcha por la demanda y pueden cambiar sin previo aviso mientras dejan entrar a más usuarios. De hecho, ya han cambiado: el 25 de septiembre eran 250.000 tokens por segundo y 1.200 peticiones por minuto.
La propia empresa pone una advertencia sobre ese precio en el anuncio de lanzamiento: no puede demostrar que no esté subvencionado y necesitará tiempo para probar que es sostenible, aunque espera que baje y no que suba.
Para probarlo sin programar está el Playground que se explica más arriba. La vía gratuita que circuló estos días ya no existe: en Vercel AI Gateway, Jev tuvo un precio promocional de cero hasta el 25 de septiembre de 2026, y el 28 de septiembre la ficha de Jev en Vercel AI Gateway ya lo mostraba a 0,04 dólares por millón de tokens de entrada —la tarifa de TypeSafe, redondeada— con dos proveedores a elegir, TypeSafe AI y DigitalOcean.
Lo que supone para el volumen de una pyme
Este cálculo es nuestro, no de TypeSafe, y los supuestos van declarados para que los cambies por los tuyos. Tomamos 400 tokens de entrada por mensaje, porque el ejemplo de la guía de inicio rápido, un mensaje corto con tres preguntas, gasta 392. Y un negocio que recibe 60 mensajes al día:
- Con Jev: unos 0,03 dólares al mes. 60 mensajes por 30 días son 1.800 mensajes y 720.000 tokens; a 0,042 dólares el millón, 0,03 dólares.
- Con GPT-6 Luna, el modelo barato de OpenAI: unos 0,10 dólares al mes. Con los 0,10 dólares por millón de tokens de entrada y 0,50 de salida de su ficha de modelo, y 30 tokens de salida por clasificación: 0,072 de entrada más 0,027 de salida, sin contar tokens de razonamiento. Lo explicamos al cubrir el precio de GPT-6 Sol y Luna en la API de OpenAI.
La conclusión es la que parece: con el volumen de una pyme, el precio del modelo no decide nada, porque los dos se quedan en céntimos al mes. Lo que decide es si el formato de respuesta es fiable, si la confianza te sirve para saber cuándo pasar el caso a una persona y si acierta en español con tus mensajes. El ahorro de Jev pesa de verdad cuando se cuentan millones de decisiones, no unos pocos miles al mes.
Cuál es la página oficial de Jev IA
La oficial es typesafe.ai. De ella cuelgan el blog y la empresa; la documentación está en docs.typesafe.ai, la consola con el Playground y las claves en console.typesafe.ai y la API en api.typesafe.ai.
Lo decimos porque en la búsqueda de «jev ai» que hicimos desde España el 25 de septiembre, ninguno de los tres primeros resultados orgánicos era de TypeSafe, y dos de ellos llevan «jevai» en el dominio. El anuncio oficial aparecía en sexto lugar, por debajo de Wikipedia. Google personaliza los resultados, así que tu orden puede ser distinto, pero los dominios se comprueban igual:
- jevai.org se define en su portada como sitio de comunidad y remite a TypeSafe AI para la documentación y la API oficiales.
- jevai.net se presenta como «Jev AI», firma «© 2026 Jev AI» y recoge contactos con un formulario y un correo de su propio dominio. No enlaza a typesafe.ai en ninguna de sus versiones. El botón principal de prueba, también en la española, lleva a defapi.org, una plataforma de acceso por API a modelos de varios proveedores, con parámetros de referido.
- ADSLZone tenía el tercer puesto con un artículo de noticias del 22 de septiembre.
Algo más abajo aparecía jev-ai.pro, que en sus preguntas frecuentes se declara «independent playground and API», es decir, una plataforma independiente con sus propias suscripciones, saldo de tokens y soporte.
Tres días después, el 28 de septiembre, la misma búsqueda ponía jevai.net en el primer puesto y el anuncio oficial de TypeSafe en el cuarto. El 11 de octubre, buscando «jev ia», el quinto resultado era jevtypesafeai.com, que lleva el nombre de la empresa en el dominio pero no es typesafe.ai; el anuncio oficial salía justo debajo.
La regla práctica es sencilla: si vas a crear una cuenta, generar una clave o meter una tarjeta, hazlo en la consola de TypeSafe o en una pasarela que ya uses. Un dominio con «jev» en el nombre no es TypeSafe AI.
Jev en español: lo que dice su documentación y lo que medimos desde Madrid
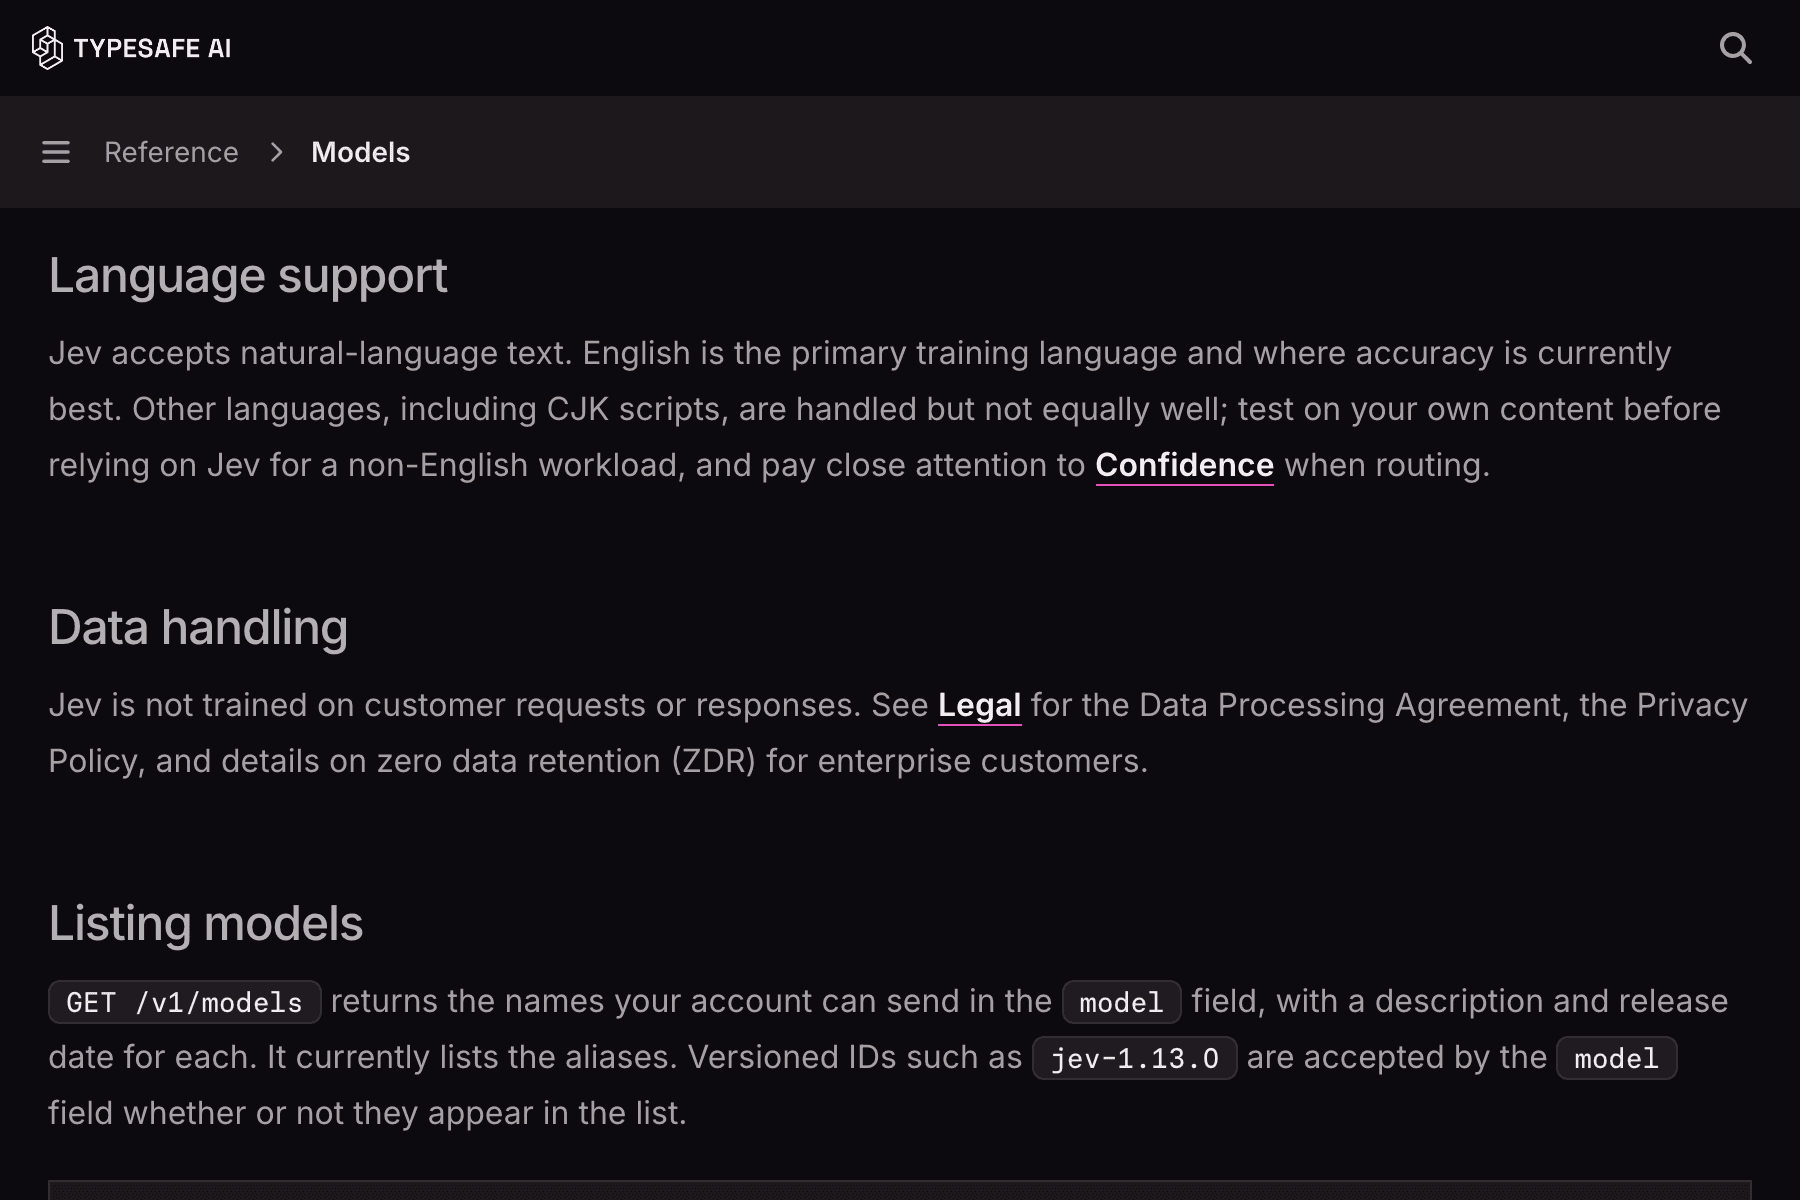
El aviso más importante para un negocio español lo da la propia TypeSafe. En el apartado de idiomas de la página de modelos —el que sale en la portada de este artículo— dice que el inglés es el idioma principal de entrenamiento y donde la precisión es hoy mejor; que otros idiomas se procesan, pero no igual de bien; y que hay que probar con tu propio contenido antes de confiar en Jev para un trabajo que no esté en inglés, vigilando la confianza al enrutar.
Ni los tres primeros resultados de Google para «jev ai» ni la respuesta del Modo IA lo mencionaban. Y para una pyme que atiende por WhatsApp es el dato que más pesa, porque sus mensajes no se parecen a un texto de ejemplo: abreviaturas, faltas, sin tildes, audios transcritos, mezcla de castellano y otras lenguas.
La otra comprobación la hicimos nosotros. Las cifras de velocidad de TypeSafe, de 70 a 500 milisegundos por respuesta, están medidas desde la costa oeste de Estados Unidos: el anuncio aclara que sus pruebas se hacen desde portátiles de la empresa allí, «donde está el servicio». Así que medimos el camino desde aquí.
- Dónde está la API. El dominio api.typesafe.ai resolvía a dos direcciones que la lista pública de rangos de IP de Amazon Web Services asigna a la región us-west-2, en Oregón.
- Cuánto tarda la red. Cinco peticiones sin clave, lanzadas el 25 de septiembre desde una conexión en la Comunidad de Madrid: la conexión se abrió en 0,20 a 0,31 segundos; la conexión segura estaba lista entre 0,43 y 0,53 segundos; y la respuesta de error por falta de clave, en la que el modelo no hace ningún trabajo, llegó entre 0,64 y 0,87 segundos.
Traducido: desde España cada ida y vuelta a la API cuesta entre dos y tres décimas de segundo antes de que Jev piense nada, y una conexión nueva, más de medio segundo. Para contestar un WhatsApp da igual, porque el cliente no nota medio segundo. Para un proceso que encadena decisiones en tiempo real, hay que reutilizar conexiones o contar con esa espera.
Qué pasa con los datos que le mandas
Los datos viajan a Estados Unidos y TypeSafe no entrena con ellos. La política de privacidad, actualizada el 19 de noviembre de 2025, dice que los servicios están alojados en Estados Unidos y que quien los usa desde el Espacio Económico Europeo transfiere allí sus datos personales. La misma política, y también la página de modelos, dicen que no entrenan ni ajustan modelos con lo que les envías.
El acuerdo de tratamiento de datos, actualizado el 24 de abril de 2026, sitúa a TypeSafe como encargado del tratamiento y a ti como responsable. Para las transferencias desde la Unión Europea recurre a las cláusulas contractuales tipo de la Comisión Europea, las de la Decisión de Ejecución 2021/914, y fija como autoridad de control competente para interesados del Espacio Económico Europeo a la de Irlanda. La retención cero de datos existe, pero la documentación la reserva a clientes de empresa.
Qué significa esto en la práctica, sin ser asesoramiento jurídico:
- Si los mensajes llevan datos personales, y los de clientes los llevan, es una transferencia internacional. Tiene que constar en tu registro de actividades de tratamiento y en tu información de privacidad, como cualquier otro proveedor de Estados Unidos. Revísalo con quien lleve tu protección de datos antes de conectar nada.
- Manda solo lo que la pregunta necesita. Quita nombres y teléfonos antes de enviar el texto. Aquí privacidad y precisión van en la misma dirección: la página de limitaciones pide filtrar el estado y dejar fuera lo que no hace falta, porque el texto irrelevante le resta acierto.
- Cuidado con la salud. Una clínica que clasifica mensajes de pacientes está enviando datos de salud, que el RGPD protege como categoría especial. Esa es una conversación que hay que tener antes, no después.
- Si Jev decide algo sobre una persona, la decisión automatizada tiene reglas. Puntuar candidaturas o solicitudes con efectos sobre alguien entra en el terreno del artículo 22 del RGPD, como recordó la AEPD al advertir a una empresa antes de que puntuara currículums con IA.
Para qué le sirve a una pyme y cuándo no merece la pena
Jev encaja cuando hay volumen y la decisión tiene respuestas cerradas. Estos son los usos con más sentido en un negocio pequeño:
- Clasificar lo que entra. Mensajes de WhatsApp, correos o formularios, por intención, y mandarlos a quien corresponde.
- Detectar urgencia o enfado para adelantar un caso antes de que se enfríe o se complique.
- Decidir cuándo pasa a una persona, con la confianza como umbral en lugar de una lista de palabras clave.
- Revisar la respuesta de otro modelo antes de enviarla. ¿Promete un precio que no está en la tarifa? ¿Da una indicación médica? ¿Confirma una cita que no existe? La documentación tiene una receta específica para usar Jev como filtro de lo que entra y sale de un asistente.
- Ordenar un histórico grande de una vez: etiquetar miles de contactos, reseñas o incidencias antiguas.
Y no merece la pena en estos casos:
- Cuando hay poco volumen. Diez mensajes al día los clasifica una persona sin montar nada.
- Cuando la tarea es redactar, resumir o conversar. Para eso están los modelos generativos.
- Cuando la decisión es un cálculo. Importes, fechas, plazos y recuentos, al código.
- Cuando nadie lo va a integrar. No hay aplicación que instalar ni chat al que escribir: Jev se usa por API o con los SDK de Python y JavaScript, así que hace falta alguien que lo programe dentro del flujo.
Ejemplo: una clínica dental que recibe 60 WhatsApp al día
Es un ejemplo construido para explicar el funcionamiento, no un cliente, y no mostramos respuestas de Jev porque no publicamos mensajes de clientes. Llega esto a las once de la noche:
Hola, se me ha caído un empaste y me duele bastante. ¿Me podéis ver mañana? Si no, el jueves por la tarde.
En una sola llamada, la automatización le haría cuatro preguntas sobre ese texto:
- Intención, de tipo Choice: pedir cita, cambiar o anular una cita, preguntar un precio, urgencia dental u otra cosa. Cada opción con una frase que diga cuándo aplica, porque Jev lee de forma literal.
- Urgencia, de tipo Score: 0 sin prisa, 1 quiere cita pronto, 2 dolor, rotura o sangrado.
- Petición de una persona, de tipo Noul: «el paciente pide hablar con alguien de la clínica».
- Día y franja que pide, también de tipo Choice: hoy, mañana, uno de los días de la semana o «no lo dice»; y mañana, tarde o «no lo dice». Si da dos preferencias, se pregunta por cada una por separado. Jev no compara fechas, así que no se le pregunta qué fecha es: extrae las piezas y el código de la agenda las convierte en una fecha real.
Y aquí el español ya pone una trampa que un texto de ejemplo en inglés no tiene: «mañana» puede ser el día siguiente o la franja de la mañana. El criterio de cada opción tiene que decir cuál es cuál, porque Jev va a leer exactamente lo que pongas.
Y el código decide con las respuestas:
- Urgencia 2 con confianza alta: aviso inmediato a recepción y primer hueco de urgencias que ofrezca la agenda.
- Petición de cita con confianza alta: huecos que encajen con el día y la franja que pidió.
- Confianza por debajo del umbral en la intención: a una persona, sin adivinar.
Lo que no hace Jev es escribir la respuesta. Eso lo hace una plantilla o un modelo generativo; y si lo hace un modelo generativo, Jev puede comprobar antes de enviarla que no incluye precios ni indicaciones clínicas. Los umbrales no los ponemos aquí a propósito: se ajustan con los mensajes de cada negocio.
Cómo probarlo con tus mensajes antes de fiarte
Si después de todo lo anterior quieres probarlo, esta es la prueba que haríamos antes de conectarlo a un canal real:
- Elige una sola decisión repetida y con respuestas cerradas, por ejemplo la intención de los mensajes de WhatsApp.
- Junta cien mensajes reales recientes, quita nombres y teléfonos y etiquétalos a mano. Esa es tu referencia.
- Escribe las opciones con criterios explícitos, una frase por opción, y añade siempre una opción de «otra cosa».
- Pásalos por el Playground o por la API y compara con tus etiquetas. Mira aparte los que salieron con confianza baja: ahí está la mitad de la información.
- Fija umbrales por riesgo. Enviar un mensaje de horario puede ir solo; anular una cita, no.
- Fija la versión,
jev-1.13.0, en lugar del alias, si has ajustado umbrales. La documentación avisa de que el alias cambia cuando sale una versión nueva y las respuestas pueden moverse sin que toques nada. - Repite la prueba con los peores mensajes de tu clientela: abreviaturas, sin tildes, audios transcritos. Es donde el aviso del idioma se va a notar.
El análisis de PotencIA
Separado de los hechos, esta es nuestra lectura.
La novedad de Jev no es que sea más listo que un modelo de lenguaje. Es que obliga a diseñar la automatización como debería diseñarse siempre: una decisión cerrada, con una probabilidad, y el código al mando. Es el criterio con el que montamos las automatizaciones de WhatsApp con IA de PotencIA. En un asistente de citas, el paso crítico no es redactar la respuesta; es decidir qué quiere el cliente: reservar, preguntar un precio, cambiar una cita o hablar con alguien. Ahí es donde las automatizaciones fallan en silencio, y Jev es un modelo construido solo para ese paso.
En PotencIA ya lo usamos en producción, en uno de nuestros asistentes. Ahí Jev hace de guarda: toma las decisiones previas a cada respuesta, y el texto que recibe el cliente lo escribe otra pieza. Llegamos a eso después de probarlo con nuestros propios mensajes, que es exactamente lo que recomendamos en el apartado anterior.
Para una pyme que atiende en español, Jev es una pieza para probar, no para adoptar a ciegas. Por cuatro razones, tres de ellas escritas por la propia TypeSafe: el fabricante avisa de que el español no es su punto fuerte; los datos se procesan en Estados Unidos; el acceso es anticipado, con límites que cambian sin aviso; y, esta ya es cuenta nuestra, con volumen de pyme el precio no es el argumento. Donde lo probaríamos primero es en los dos sitios donde un error suyo no empeora lo que ya tienes: como segundo control de las respuestas de otro modelo antes de enviarlas, y para ordenar un histórico grande que después revisa una persona.
Y una idea que sirve aunque no uses Jev nunca: el formato se puede adoptar ya con cualquier modelo. Opciones cerradas, una medida de confianza y paso a una persona cuando no está claro. Es lo que contamos en cómo automatizar WhatsApp Business con IA sin perder el control.
Otras dudas que aparecen al buscar Jev IA
¿Jev AI tiene chat? No. El Playground de TypeSafe es un banco de pruebas donde pegas un texto y añades preguntas; no conversa ni contesta con frases.
¿Dónde se inicia sesión? En la consola de TypeSafe, console.typesafe.ai, que es donde están el Playground y las claves de API.
¿Está en GitHub o es de código abierto? No. El modelo es propietario y no se descarga. En GitHub, TypeSafe publica su skill para asistentes de programación, en el repositorio typesafe-ai/skills; los repositorios de terceros que imitan su funcionamiento no son Jev.
¿Se puede descargar o usar en local? No. Jev no se descarga ni tiene aplicación: se usa a través de la API de TypeSafe o de las pasarelas que su documentación recoge, OpenRouter y Vercel AI Gateway. La documentación no contempla instalarlo en tu equipo. Si te ofrecen «descargar Jev», no es de TypeSafe.
¿Jev es gratis? No. Se paga por uso, 0,042 dólares por millón de tokens de entrada, y la documentación no publica ningún plan gratuito. Lo que sí es gratis es la salida. Para probarlo hace falta una cuenta en la consola de TypeSafe, donde está el Playground.
Cómo se ha verificado esto
Las fuentes de TypeSafe se han leído el 25 de septiembre de 2026 y todas respondieron con HTTP 200 a la lectura directa. La documentación se ha leído en su versión en Markdown, que es la que la propia TypeSafe ofrece para cada página. La portada es una captura de la página de modelos hecha ese mismo día, sin recortes.
El 28 de septiembre se reabrieron la página de modelos, el índice de la documentación y la ficha de Vercel: la documentación de TypeSafe no había cambiado y la promoción de Vercel había terminado. Los pasos de uso salen de la guía de inicio rápido, la referencia de la API, las páginas de los SDK y la de la skill, leídas ese mismo día, y la búsqueda de «jev ai» se repitió también entonces.
La revisión de Google se hizo el mismo día desde España, con sesión iniciada. Los resultados de Google están personalizados, así que el orden citado es el que vimos y puede no coincidir con el tuyo. La respuesta del Modo IA se consultó con la búsqueda «qué es jev ai». De cada dominio citado se ha leído la portada: lo que se dice de ellos sale de su propio texto y de sus enlaces.
La medición de red es nuestra: cinco peticiones sin clave al punto de la API que lista los modelos, con los tiempos que devuelve curl, desde una conexión en la Comunidad de Madrid. Las direcciones se han contrastado con la lista de rangos de IP que publica Amazon Web Services, en su versión del 25 de septiembre. No mide lo que tarda el modelo, solo la red y el servidor.
El 11 de octubre se reabrieron la página de modelos (límites de uso nuevos y alias jev-preview; precio, idiomas y datos sin cambios), la guía de inicio rápido y la ficha de Vercel, que sigue a 0,04 dólares con TypeSafe AI y DigitalOcean como proveedores. Ese día se leyeron también el anuncio de la ronda y el caso de Jack & Jill en el blog de TypeSafe, el anuncio de Andreessen Horowitz, con fecha del 9 de octubre en los metadatos, la guía de la API de decisiones de OpenAI y el anuncio de Microsoft-Decision-1, fechado el 9 de octubre. El post de TypeSafe sobre la ronda no lleva fecha visible: la del 9 de octubre sale del de Andreessen Horowitz. La web jevtypesafeai.com no respondió a la lectura automatizada ni desde un navegador, así que de ella solo se afirma que su dominio no es el de TypeSafe.
El cálculo de coste mensual es nuestro, con los supuestos declarados en su apartado. El ejemplo de la clínica es construido. Para escribir esta pieza no se ha usado ninguna clave de API ni se ha enviado ningún dato a Jev; el uso de PotencIA en producción que se cita en el análisis es aparte, y de él no publicamos cifras. Las actualizaciones del 28 de septiembre y del 11 de octubre se decidieron mirando en Search Console por qué búsquedas aparece esta página; no se ha solicitado su indexación.
Fuentes consultadas
- Introducing System One Models & Jev, blog de TypeSafe AI, 15 de septiembre de 2026: lanzamiento en acceso anticipado, precio, velocidad, garantía de cero errores de tipo, origen de los nombres y matices sobre sus propias pruebas.
- Equipo de TypeSafe AI, consultado el 25 de septiembre: fundadores, cargos y sede.
- Introducción, primitivas, System One y confianza, documentación de TypeSafe AI, consultadas el 25 de septiembre: funcionamiento, tipos de pregunta, calibración y uso de la confianza.
- Modelos, documentación de TypeSafe AI, consultada el 25 y el 28 de septiembre: versión, precio, límites de uso, reintentos de los SDK, contexto, idiomas y tratamiento de datos.
- Limitaciones de jev-1.13, documentación de TypeSafe AI, revisada por TypeSafe el 17 de septiembre y consultada el 25: modos de fallo conocidos y cómo evitarlos.
- Jev with coding agents y guía de inicio rápido, documentación de TypeSafe AI, consultadas el 25 y el 28 de septiembre: qué no es Jev, cómo se prueba en el Playground, requisitos del SDK de Python y el ejemplo de 392 tokens de entrada.
- Referencia de la API, SDK de JavaScript, uso del SDK de Python y skill para agentes, documentación de TypeSafe AI, consultadas el 28 de septiembre: punto de la API y cabecera de autenticación, instalación de los SDK y de la skill, y modelos de OpenRouter y Vercel AI Gateway.
- Política de privacidad, actualizada el 19 de noviembre de 2025, y acuerdo de tratamiento de datos, actualizado el 24 de abril de 2026, de TypeSafe AI: alojamiento en Estados Unidos, no entrenamiento con datos de clientes, cláusulas contractuales tipo y autoridad de control.
- Ficha de Jev en Vercel AI Gateway, consultada el 25 y el 28 de septiembre: proveedores, precio promocional con su fecha de fin y tarifa posterior.
- Ficha de GPT-6 Luna, documentación de la API de OpenAI, consultada el 25 de septiembre: precio de entrada y de salida por millón de tokens, usado solo para la comparación de coste.
- TypeSafe A raises Series AI y caso de Jack & Jill, blog de TypeSafe AI, consultados el 11 de octubre: ronda, inversores, valoración, «un tercio» del Fortune 500 y cifras del caso.
- Investing in TypeSafe AI, Andreessen Horowitz, 9 de octubre de 2026: un billón de tokens en tres días y el 25 % del Fortune 500.
- Decisions, documentación de la API de OpenAI, consultada el 11 de octubre: beta pública, GPT-6 Luna, tipos de pregunta y entrada de imágenes.
- Introducing Microsoft-Decision-1, Microsoft, 9 de octubre de 2026: disponibilidad, modelo base y precio.
- Rangos de IP de Amazon Web Services, versión del 25 de septiembre de 2026: región de las direcciones de la API.